
被當了五十年"例外"的快閃記憶體,正在變成推理的主幹道
一位在 Sandisk 負責系統架構與平台工程、早年在 Intel 參與最早一批多核 CPU 設計的工程師,最近公開拋出一個判斷:AI 推理把體系結構五十年的默認前提翻了面。過去被刻意躲開的記憶體訪問,成了新的關鍵路徑。2026年09月的市場資料顯示,錢已經跟著這個判斷砸下去了。
聚焦 🔍
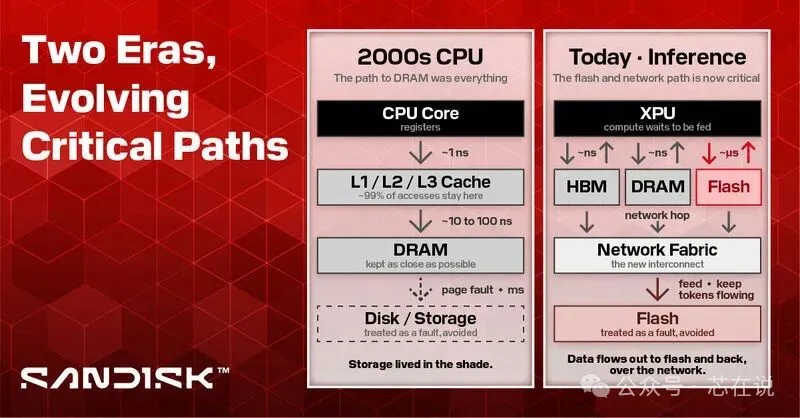
核心命題只有一句:資料現在住的地方,恰好是這台機器當初被設計成儘量不去的地方。長上下文、KV 快取、RAG 把"每個有效 FLOP 要搬多少字節"推得太高,DRAM 裝不下也擴不動,資料只能沉到快閃記憶體,路徑還得跨網路。
舊世界:整台機器都在躲記憶體
那位作者回憶,2000年代他造多核 CPU,把晶片組、記憶體控製器、PCIe 核和 root complex 一起收進 CPU die,全部心思都在縮短通向 DRAM 的路。那時快取未命中是罰款,缺頁是事故,使用者能直接感覺到。整套層級就是圍繞"別出門"調出來的。
翻面:資料搬了家,路沒跟著搬
推理不一樣。先算一筆帳,口徑粗,後面會解釋為什麼故意粗。Llama 3 70B 有80層、8個 KV 頭、頭維度128,按 FP16 存,每個詞元的 KV 約320KB。一個128K 上下文的會話,光 KV 就約43GB。單卡 80GB 視訊記憶體裝完 FP8 權重,剩下的連一個會話都放不下。
DRAM 更擴不動,快閃記憶體又是整條鏈路里容量和成本結構唯一對得上的那一層。可快閃記憶體比 DRAM 遠三個數量級,中間還隔著網路,而五十年的最佳化幾乎全砸在了 DRAM 那條路上。作者的說法是:例外變成了主路,卻沒繼承任何主路該有的最佳化。
洞察 💡
這裡有個反直覺點。Sandisk 的 CTO 公開表示,推理裡起決定作用的是頻寬而不是延遲,頻寬可以用別的辦法造出來。KV 回填是大塊、可預測、能提前排隊的讀,天然適合流水預取,不像缺頁那樣只能幹等。所以"快閃記憶體慢三個數量級"不等於"快閃記憶體不能當主路",前提是把它當頻寬資源調度,別當隨機訪問裝置用。
帳單已經在響
TrendForce 在2026年09月01日披露,2Q26 前五大企業級 SSD 廠商營收約375.9億美元,環比增長103.6%。Sandisk 排第五,營收近29.8億美元,環比增長102.9%,驅動力是高容量 QLC 企業級 SSD 進入放量期。漲價的勢頭在降溫,3Q26 企業級 SSD 合約價漲幅已縮小到20%-25%,供應商擴大了產品供給。
架構層面的動作更早。NVIDIA 在2026年1月5日的 CES 上宣佈 BlueField-4 驅動的推理上下文記憶體記憶體平台,官方稱能效最高達傳統記憶體的5倍。它在推理記憶體層級裡新增了一層 G3.5,也就是乙太網路掛載的快閃記憶體,專門服務 KV 快取。BlueField-4 整合800Gb/s 網路連線和64核 Grace CPU,等於把"通向快閃記憶體的那段路"做成了專用硬體。
快閃記憶體這邊想往更近的地方爬。HBF 的目標是頻寬與 HBM 相當,容量做到 HBM 的8到16倍,成本相近,首批樣品目標在2026年下半年,搭載 HBF 的推理裝置樣品預計2027年初。2026年02月25日,Sandisk 與 SK hynix 宣佈在開放計算項目下成立 HBF 標準化工作組。
我為什麼只信一半
說實話,這篇原文我只信一半。作者所在公司賣快閃記憶體,"最有意思的工程問題"這個定語自帶立場,讀的時候得扣掉一檔。
警示 ⚠️
三個口徑要盯住。第一,NVIDIA 的"5倍"是廠商口徑,基線是"傳統記憶體",基線怎麼選決定了數字好不好看。第二,模型側有逃生門,KV 量化、MLA 這類壓縮手段能把 KV 體積砍掉一半甚至一個量級,需求曲線未必像上面那筆帳那麼陡。第三,HBF 樣品是否已如期交付,我沒查到明確的公開說法,別把路線圖當出貨。
再說個我自己的事。有年在深圳,凌晨兩點,我盯著一套長上下文推理服務的 p99 曲線,KV 一溢出到本地盤,曲線就抽風。當時罵的是盤,後來想明白該罵的是我自己排的路徑:資料搬對了地方,預取沒跟上。
我老家洛陽有道席叫水席,二十四道菜,名字裡的"水"是說菜像流水一樣一道接一道上,吃完撤一道。桌子從來不擺滿,擺滿了就涼。後廚到桌面之間那條傳菜的路,才是水席的手藝。寫到這我自己都笑了,這不就是預取嗎。當然人不是程式碼,菜涼了還能將就吃,快取涼了就是 p99。
詞元帳:從這裡反推 HBM
接下來這段我故意用最粗的口徑,就為了讓你想糾正我。
關鍵 📌
70B 模型的預填充約需每詞元140GFLOP,按單卡有效400TFLOPS 粗估,重算一個128K 前綴要幾十秒。把43GB 的 KV 從一塊 PCIe5.0 SSD 讀回來,按單盤約14GB/s 算,約3秒。一次前綴命中省下的是十余倍量級的時間。數字對不對,評論區來打,我的 KV 全按 FP16 算,FP8 直接減半。
順著這筆帳往回推,會得到一個反共識的結論:HBM 缺,未必是因為算力真需要那麼多頻寬,而是它被拿來兼職"停車場",停了一堆本該在下一層等著的冷 KV。詞元成本裡有一大塊是重複預填充,是容量焦慮逼出來的浪費。把冷資料體面地挪走,緩解的是 HBM 的容量壓力,不是頻寬壓力。記憶體漲價也不完全是缺貨,一部分是這場層級重排的預付款。
還有個衝突沒人願意細說。KV 快取丟了可以重算,它不需要企業資料那套持久性和冗餘。可 QLC 企業級 SSD 每GB 價格與 HDD 的差距已擴大到約15倍,如果 KV 不要持久,是不是該有一檔"不那麼企業級"的便宜快閃記憶體?這條路誰先走通,誰定價格。
行動含義:一張能直接拿去吵架的矩陣
機會 ✅
給做推理架構的人三個自檢問題:你的詞元裡有多大比例是重複前綴?你的 p99 是卡在頻寬還是尾延遲?你的 KV 真的需要持久嗎?答完這三個,你就知道自己的瓶頸在 HBM、在網路,還是在調度。真正的機會不在多買那一層,在誰先把"通向快閃記憶體的那條路"當成一等公民來最佳化。
這話我說得不客氣:流量不是演算法給的,是人性漏出來的。同理,記憶體漲價不是缺貨,是帳期遊戲,而帳期遊戲的底牌,是那條沒人最佳化過的路。
昨晚又是一個凌晨,螢幕上那條 p99 曲線終於平了。我盯著它看了半天,腦子裡冒出來的居然是老城十字街早上那碗漿面條,熱氣頂著碗沿,一口沒涼。 (芯在說)