
黃仁勳為什麼支援Reflection?「美國版DeepSeek」殺出來了
黃仁勳,又盯上了一門大生意。
這一次,不是賣GPU,也不是發佈下一代AI晶片,而是要補上美國AI產業越來越明顯的一塊短板——開放大模型。
10月4日,據Axios報導,輝達支援的AI創業公司Reflection AI正在準備推出首個重量級open-weight開放權重模型。
更有意思的是它瞄準的對手。
不是只有OpenAI的GPT、Anthropic的Claude或者Google Gemini,而是來自中國的DeepSeek、Qwen等開放模型。
消息人士稱,Reflection首款重量級模型雖然可能暫時落後於美國最頂尖的閉源前沿模型,但預計能夠直接與中國領先開放權重模型競爭。
事情一下變得有意思了。
過去兩年,美國擁有OpenAI、Anthropic、Google,幾乎包攬全球最強閉源大模型;
但另一邊,DeepSeek、Qwen、Kimi等中國AI模型卻在開放生態裡瘋狂擴張。
美國突然發現:
最強的AI可能還在自己手裡,但越來越多開發者使用的開放模型,卻未必來自美國。
現在,黃仁勳準備親自補上這個缺口。
一個「美國版DeepSeek」,殺出來了。
1、美國突然急了:DeepSeek、Qwen正在搶地盤
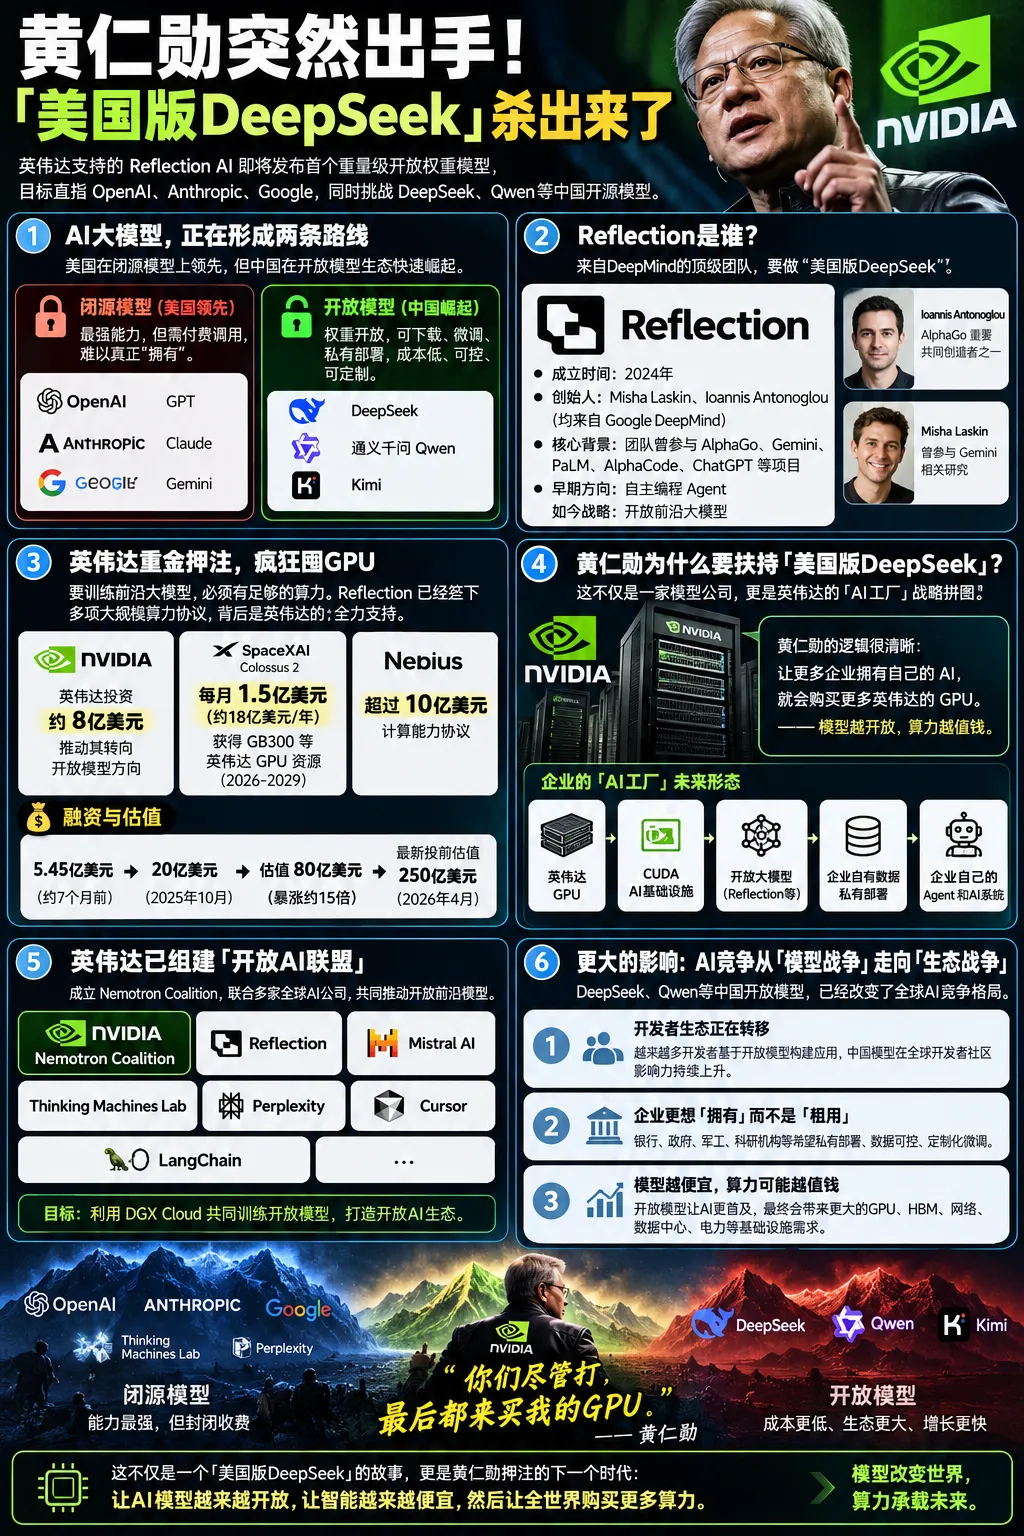
AI大模型正在形成兩個完全不同的世界。
一個世界屬於OpenAI、Anthropic和Google。
GPT、Claude、Gemini不斷刷新能力上限,但核心模型基本掌握在公司自己手裡。開發者可以付錢呼叫API,卻很難真正「擁有」它。
另一個世界,則屬於DeepSeek、Qwen等開放模型。
模型權重開放之後,開發者可以下載、微調、私有部署,甚至把模型直接裝進自己的伺服器和資料中心。
區別看起來只是「開源還是閉源」,背後爭奪的卻可能是未來AI世界的入口。
尤其對於銀行、政府、國防、科研機構和大型企業而言,它們越來越不滿足於「租一個AI」。
它們更希望:
把模型部署在自己的伺服器上,接入自己的資料庫,使用自己的算力,資料不用交給第三方,最終訓練出一個真正屬於自己的AI。
這恰恰是DeepSeek、Qwen等開放模型迅速擴張的重要原因。
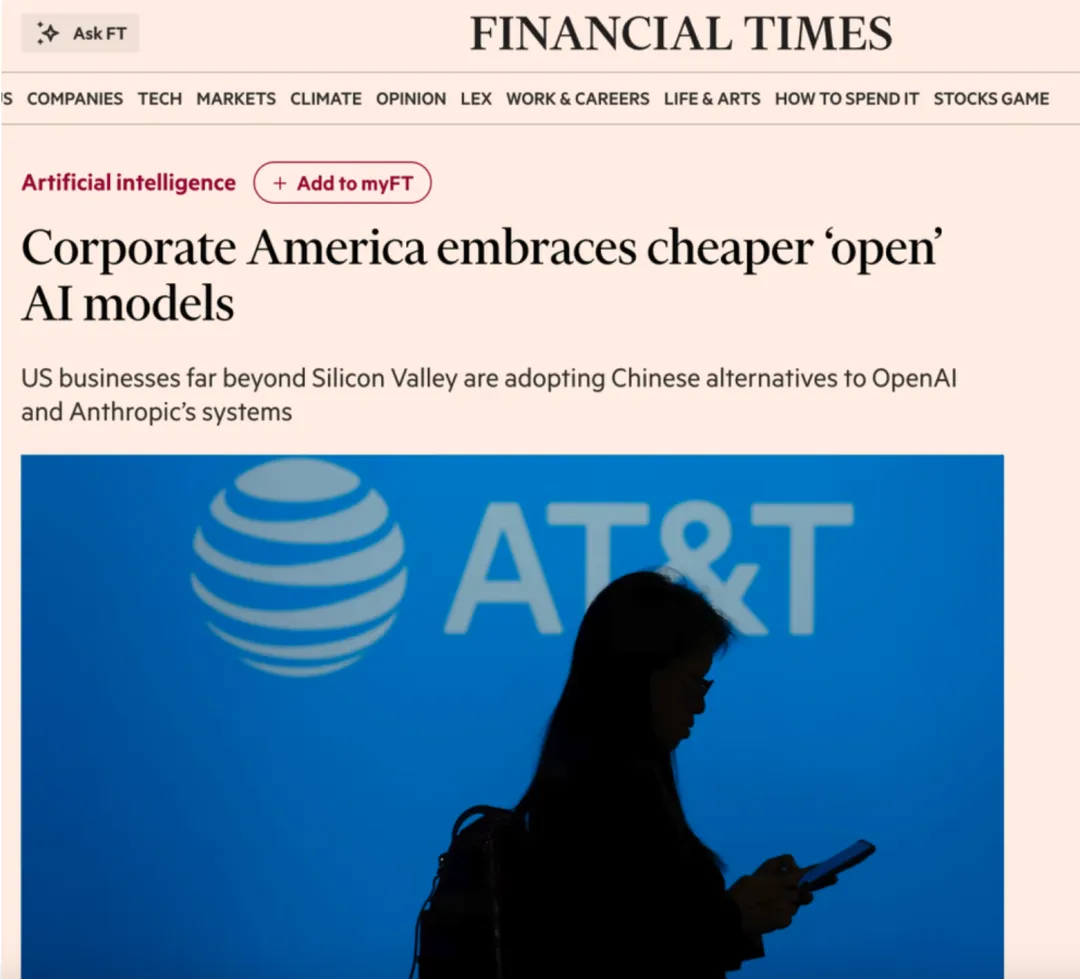
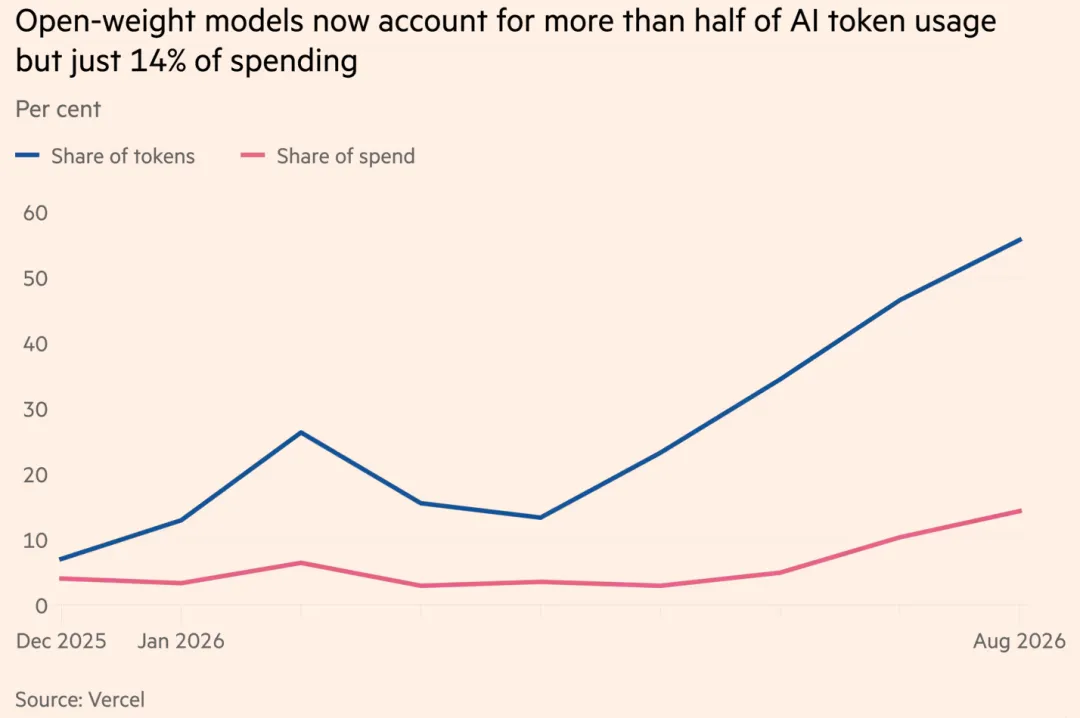
Axios今年6月就曾指出,全球最強、使用最廣泛的一批開放模型越來越多來自中國廠商,中國AI模型已經在OpenRouter等開發者生態中佔據重要位置。
美國AI產業開始意識到:
如果這種趨勢繼續下去,未來被搶走的可能不只是一部分模型市場。
還有全球AI開發者生態。
2、誰是Reflection?AlphaGo大神出來創業了
黃仁勳選中的Reflection,並不是一家普通AI創業公司。
Reflection成立於2024年,兩位創始人Misha Laskin和Ioannis Antonoglou都來自Google DeepMind。
其中,Antonoglou還有一個非常醒目的標籤:
AlphaGo重要共同創造者之一。
2016年,AlphaGo擊敗李世石,成為人工智慧歷史上最具標誌性的事件之一。
如今,參與創造AlphaGo的人,開始挑戰新一輪AI戰爭。
Reflection隨後還吸引了大量來自DeepMind和OpenAI的人才。按照公司官方介紹,團隊成員曾參與PaLM、Gemini、AlphaGo、AlphaCode、AlphaProof、ChatGPT等項目。
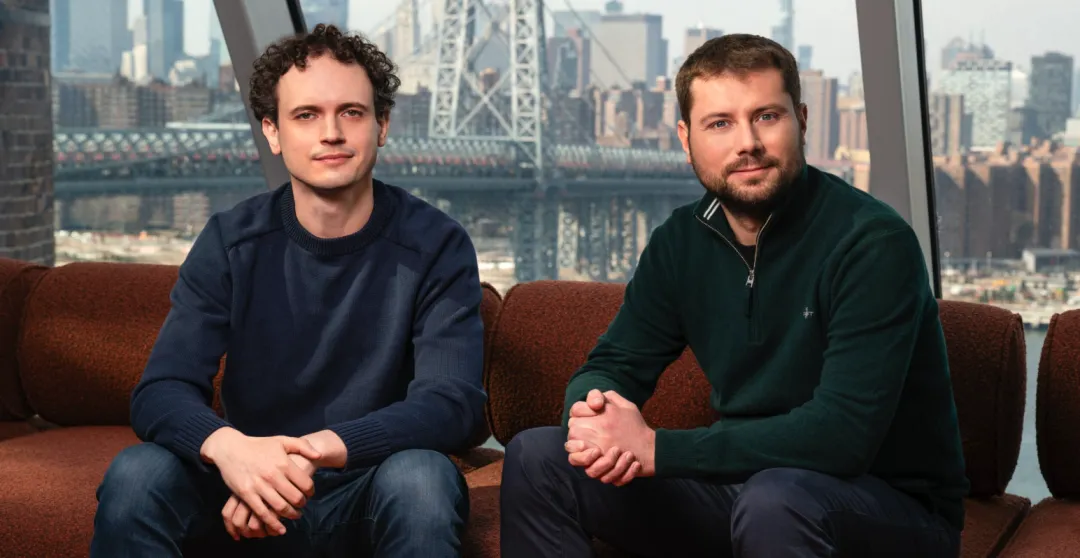
Reflection AI Co-Founders Misha Laskin and Ioannis Antonoglou.
這意味著Reflection不是簡單套一個現成模型做應用。
它想自己訓練前沿大模型。
更關鍵的是,Reflection最開始做的其實是自主程式設計Agent,後來卻突然把戰略重點轉向開放前沿模型。
而這次轉向背後,站著一個關鍵人物:
黃仁勳。
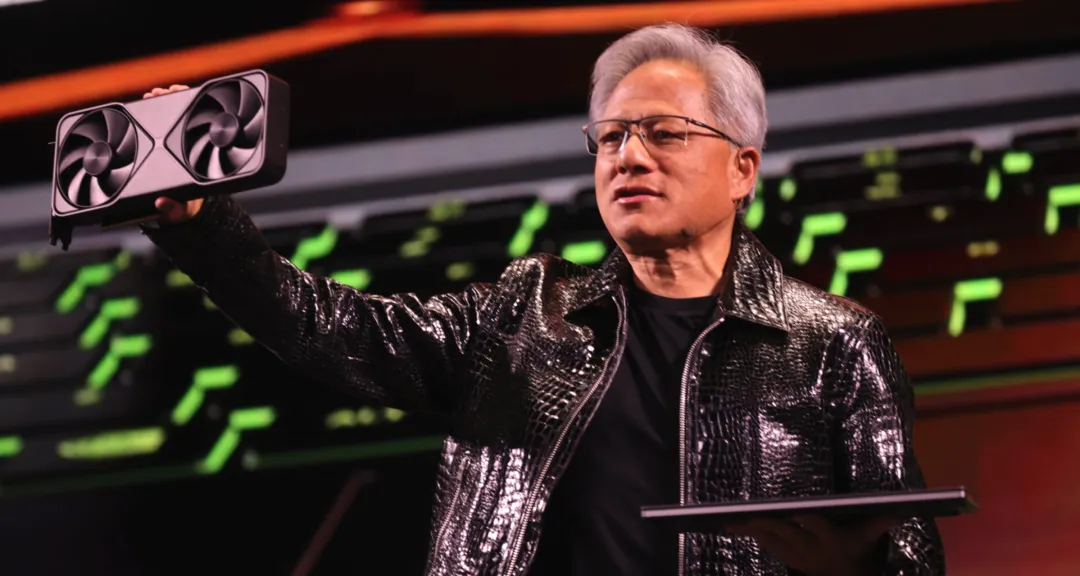
據The Information此前報導,Reflection聯合創始人與黃仁勳會面後,輝達推動並支援其向開放模型方向轉型,隨後向Reflection投入約8億美元。
這個「美國版DeepSeek」背後,站著全球最大的AI晶片公司。
3、瘋狂燒錢!狂囤GPU!
有了人,還遠遠不夠。
想做前沿大模型,還需要AI時代最昂貴的「燃料」:
GPU。
Reflection已經開始瘋狂囤算力。
2026年6月,Reflection與SpaceXAI簽署大型算力協議,獲得Colossus 2資料中心中的輝達GB300等先進GPU資源。
按照Axios披露的資訊,Reflection完成初期爬坡後,自2026年7月開始每月支付約1.5億美元,相關協議最長可以持續至2029年。
每個月1.5億美元。
一年就是接近18億美元。
而這還沒完。
路透社7月又報導稱,Reflection與Nebius簽署超過10億美元的計算能力協議,繼續鎖定最新輝達GPU算力。
Reflection正在複製今天所有頂級AI實驗室最簡單粗暴的遊戲:
融資 → 買GPU → 訓練模型 → 獲得使用者 → 再融資 → 再買GPU。
錢也開始瘋狂湧進來。
2025年10月,Reflection完成20億美元融資,估值達到80億美元,相比大約7個月前5.45億美元的估值,暴漲約15倍。
到了2026年,公司官網列出的媒體記錄顯示,其CEO在4月確認最新融資已經按照250億美元投前估值完成。
一個旗艦開放模型尚未真正大規模殺入市場的AI創業公司,就已經被資本推向數百億美元估值。
大家賭的顯然已經不是一款模型。
而是一個位置:
「美國開放AI基礎設施」。
4、黃仁勳為什麼要親手扶持「美國版DeepSeek」?
這其實是整件事情最值得琢磨的地方。
輝達根本不缺OpenAI這樣的客戶。
OpenAI、Anthropic、Google、Meta訓練的AI模型越大,需要的GPU越多,輝達賺的錢也越多。
既然如此,黃仁勳為什麼還要親自扶持開放模型?
答案藏在輝達近年來瘋狂宣傳的一個概念裡:
AI Factory——AI工廠。
黃仁勳認為,未來的資料中心將不再只是「計算資料」,而會像工廠生產商品一樣,不斷「生產智能」。
但這裡有一個問題。
如果全世界的企業最終都直接呼叫OpenAI、Anthropic、Google的API,那麼真正控制AI入口的仍然是這些模型公司。
輝達雖然賣GPU,卻依然只是下面那個「賣鏟子的人」。
開放模型就完全不同。
未來一家企業完全可以:
購買輝達GPU → 使用CUDA → 部署Reflection/Nemotron/Mistral → 接入自己的資料 → 建立自己的Agent → 最終擁有自己的企業AI。
企業不再只是「租用ChatGPT」。
而是直接購買一座屬於自己的「AI工廠」。
誰賣這座工廠裡最貴的機器?
還是輝達。
所以Reflection真正重要的地方,不只是能不能打敗DeepSeek。
而是它可能幫助輝達建立一個完整閉環:
GPU + CUDA + 開放模型 + Agent + 企業AI + AI Factory。
這才是黃仁勳真正看中的生意。
5、輝達已經開始組建「開放AI聯盟」
如果你覺得Reflection只是一筆普通投資,那就低估黃仁勳了。
輝達已經成立Nemotron Coalition。
Reflection AI、Mistral AI、Thinking Machines Lab、Perplexity、Cursor、LangChain等一批AI公司都在其中。
目標只有一個:
推動開放前沿模型。
輝達甚至計畫利用DGX Cloud共同訓練開放模型,並圍繞Nemotron打造自己的開放AI生態。
於是,一個非常有意思的格局出現了。
OpenAI有GPT。
Anthropic有Claude。
Google有Gemini。
DeepSeek有DeepSeek。
阿里有Qwen。
而黃仁勳的玩法可能完全不同:
我不一定非要擁有唯一一個最強AI模型。
只要你們的模型,都跑在我的GPU上。
這其實特別像當年的PC時代。
微軟控制Windows,英特爾卻不需要自己開發世界上所有的軟體。
只要越來越多軟體運行在x86電腦上,處理器就會一直賣。
AI時代,輝達可能正在複製類似邏輯。
GPU是處理器。
CUDA是軟體平台。
Reflection、Nemotron、Mistral以及更多開放模型,則組成運行在上面的AI生態。
模型越開放,企業部署得越多。
企業部署得越多,需要的GPU就越多。
最終最大的贏家,可能還是輝達。
6、黃仁勳的「陽謀」:讓AI越來越便宜,然後賣更多GPU
所以回過頭再看DeepSeek,你會發現它帶來的影響可能遠遠沒有結束。
2025年DeepSeek-R1爆紅時,很多人討論的是:
DeepSeek到底用了多少GPU?
低成本訓練會不會打擊輝達?
輝達GPU還值不值錢?
但一年多之後,更大的影響逐漸浮現出來。
DeepSeek重新證明了一件事情:
開放模型,同樣可以殺進前沿AI競爭。
隨後Qwen、Kimi等中國模型繼續推動這一趨勢,全球AI競爭也開始從「誰的模型參數更大、跑分更高」,逐漸進入「誰能佔領開發者生態」的新階段。
因為未來的大模型,很可能越來越像作業系統。
真正可怕的並不是別人賣出了一台電腦。
而是越來越多開發者,開始為另一個作業系統寫軟體。
這或許才是美國科技產業真正擔心DeepSeek和Qwen的地方。
而黃仁勳給出的答案也很簡單:
既然開放模型擋不住,那就加入它。
扶持Reflection。
推動Nemotron。
拉上Mistral。
組建開放AI聯盟。
讓越來越多企業擁有自己的AI模型。
因為如果未來AI模型越來越開放、越來越便宜、越來越商品化,那麼真正稀缺的東西反而會重新向產業底層集中:
GPU、HBM、高速互連、交換晶片、CPO、光模組、液冷、資料中心和電力。
換句話說:
模型越便宜,算力可能越值錢。
這才可能是黃仁勳真正的「陽謀」。
今天所有人還在爭論GPT、Claude、Gemini、DeepSeek和Qwen誰更聰明。
黃仁勳想的可能是另一件事:
你們儘管打。
最後都來買我的GPU。
所以從表面看,Reflection是一個即將殺出來的「美國版DeepSeek」。
但從更深層看,輝達真正押注的可能根本不是Reflection這一家公司。
而是一個更大的未來:
讓AI模型越來越開放,讓智能越來越便宜,然後讓全世界購買更多算力。
這,才是輝達最熟悉的遊戲。(深科技)