
當AI開始參與研發下一代AI,人類可能已經站到「智能爆炸」前夜。
虧賊!最近超超超超火的遞迴自我改進(RSI),連AI教父辛頓都親自下場了??
咱諾貝爾物理學獎、圖靈獎得主Hinton的首篇RSI的論文,上來就研究一個相當炸裂的問題:
如果AI開始大規模參與造下一代AI。
然後,下一代AI再回來繼續加速研發。
這麼一輪輪滾下去...會不會直接跑出一條智能爆炸曲線啊?
論文名叫《What if automating AI R&D triggers an intelligence explosion?》。
參與撰寫論文的作者也堪稱AI學界全明星陣容:
22位作者裡,包括兩位AI教父Geoffrey Hinton、Yoshua Bengio,強化學習先驅Andrew Barto,OpenAI首席科學家Jakub Pachocki等一眾研究者。
這麼多AI大牛湊在一起,討論的正是AI領域最古老科幻的「智能爆炸」問題,論文核心觀點咱先來一睹為快——
- 一旦AI能完整參與造下一代AI,遞迴自我改進就可能真正閉環。
- AI研發自動化一旦越過某個臨界點,幾年才能完成的AI進步,有可能被壓縮到幾個月,甚至更短。
- 未來AI實驗室的研發規模,理論上可能從幾千人直接跳到數百萬研究員。
- 今天一年完成的AI進步,極端情況下,未來可能只需要約5周。
- 智能爆炸未必需要AI先變成超級智能,只要AI研發的自動化效率足夠高,反饋循環就可能先啟動。
所以…辛頓…老爺子…大牛們…到底圍繞RSI都說了點啥…急…
AI已經開始真正進入「造下一代AI」的流水線
智能爆炸這個詞,其實蠻古早了。
早在1965年的時候,數學家I.J. Good就設想過一種超智慧型手機器。
如果一台機器已經比人更擅長設計機器,那麼它可以繼續設計一個更聰明的版本。
新的版本繼續參與下一輪改進,一輪接一輪,最後形成一個自我強化的反饋回路。
Good當年的核心判斷其實很簡單——
如果「改進機器」這件事本身,也能被機器做得越來越好,能力增長就可能反過來繼續加速能力增長。
這套設想後來成了「智能爆炸」最經典的理論源頭,和今年大火的遞迴自我改進(RSI),其實也算一脈相承。
只不過到了今天,RSI討論的重點已經悄悄變了。
大家關心的已經不只是一台AI能不能自己改程式碼、調參數,而是一個更現實的問題:
AI能不能真正進入研發下一代AI的整套流程,並且讓這套研發流程本身越來越快?
而辛頓等人在這篇論文裡給出的一個關鍵判斷,恰恰就是:
AI開始真正進入AI研發流水線了,而且速度快得有點離譜。。。
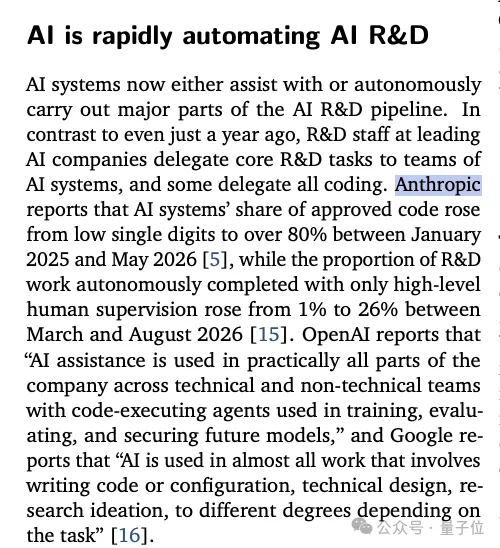
之所以這麼說,是因為論文引用了Anthropic等頭部實驗室的一批內部資料。
2025年1月,AI生成的獲批程式碼還只有低個位數比例。
才過了一年,到了2026年5月,這一比例已經超過80%。
變化更大的,是AI「自主」完成研發工作的比例。
2026年3月,Claude能夠在僅接受高層次人類監督的情況下自主完成約1%的研發工作。
到同年8月,這個數字已經升到了26%。
換句話說,半年左右,直接翻了二十多倍。
當然了,這個數字不能理解成Claude已經自動完成Anthropic四分之一的全部研究。
它主要衡量的是在高層人類監督下,可以由AI自主承擔的內部AI R&D工作比例。
Anthropic自己也強調,目前Claude還沒有在那一類被測AI研發工作上達到完全無人監督的水平,但不管咋說,趨勢已經很明顯了。
論文還提到,截至2026年9月,OpenAI內部的AI系統已經可以經常完成原本人類員工需要數天完成的研發任務。
這裡一個很關鍵的變化是AI能獨立處理的任務長度,一直在增長。
真正決定AI能不能像研究員一樣工作,關鍵並不只是某個benchmark分數有多高。
更重要的是,它能不能把幾十個步驟連續串起來,在幾個小時、幾天,甚至更長時間裡持續推進同一個研究目標。
論文綜合benchmark趨勢和實驗室內部進展,認為未來幾年,AI有可能自動化大部分AI研發工作,甚至完成全部自動化。
寫程式碼只是AI研發的一部分,這裡的完整AI R&D還包括提出研究假設、設計實驗、實現實驗、分析結果、定位失敗原因、調整路線,再重新開始。
這些環節裡,任何單獨一項被自動化,都只能算AI輔助研究,真正敏感的節點,是它們開始被串成一條長鏈。
一旦這些步驟能夠被一個AI系統長時間串起來,它承擔的角色就開始越來越接近真正的研究員。
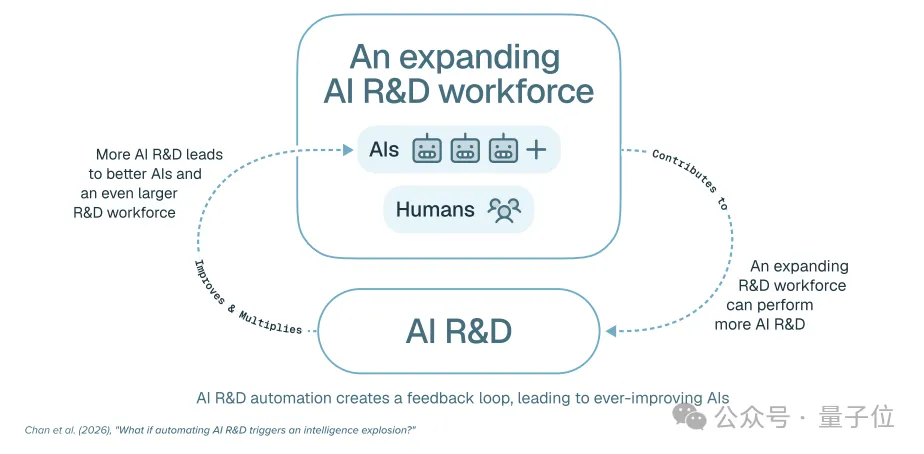
好巧不巧的是,AI研發恰好又特別適合這種自動化。。。
AI大量發生在數字環境裡,程式碼能直接執行,實驗結果可以快速返回,模型能力還能通過benchmark、loss、reward等指標立即驗證。
相比化學、生物或者製造業,AI研發少了很多必須等待現實世界反饋的環節。
也正因為如此,Good當年那個聽起來非常遙遠的循環,今天才第一次開始有了比較具體的工程路徑:
AI參與研發下一代AI,下一代AI能力更強,更強的AI再回來參與下一輪研發,循環繼續下去,研發能力本身開始參與推動研發能力增長。
論文把這類路徑稱為software-driven intelligence explosion,也就是由軟體改進驅動的智能爆炸。
主要提一嘴的是,這和造出更快晶片還有點區別。
晶片設計、流片、建廠都有長周期,而演算法、訓練方法、Agent工作流、合成資料策略一旦驗證有效,理論上可以很快重新部署進下一輪研發。
所以作者真正關心的是AI進步的反饋周期會不會越來越短,這也是今天重新討論遞迴自我改進的原因:
AI只要能夠越來越完整地接管下一代模型研發,自我改進的反饋回路就已經出現了。
幾千個研究員變成數百萬個,一年的AI進步可能只剩5周??
接下來,就是整篇論文最《抓馬》的部分了。
AI參與研發本身還不夠構成智能爆炸,真正重要的,是它和普通人類研究員存在一個非常大的區別——AI研究員可以複製。
假設一家實驗室今天有1000名頂尖研究員,未來它開發出了一個能力達到頂級人類AI研究員水平的Agent。
從這一刻開始,擴張研發團隊這件事,遊戲規則就變了。
培養一名頂尖人類研究員,可能要讀五年博士、再積累多年科研經驗,AI研究員直接再開一個實例就行~
它還能24小時工作,成千上萬個實例同時跑任務。底層模型一更新,整支AI研發團隊也能同步升級。
這就直接繞開了人類科研最硬的一層增長限制:人才培養速度。
人類想把1000名頂尖研究員變成100萬人,幾乎是代際工程。
AI系統理論上可以靠增加推理算力和實例數量,在短得多的時間裡擴張。
對此論文還專門引入了一個概念:
effective R&D workforce,也就是有效研發勞動力。
作者估算,如果AI達到頂級AI研究員水平,推理成本又與今天的前沿模型處於類似量級——
那麼一家領先AI公司的現有算力,理論上可能支撐至少數百萬名頂級人類研究員等價的AI研發勞動力。
要知道今天一家前沿AI實驗室的研究團隊,還只是幾千人量級,兩者之間差了幾個數量級。。。
而且這幾百萬個研究員還有一個人類組織很難複製的特點:能力可以同步更新。
底層模型一旦升級,不需要重新培訓幾百萬人,所有實例理論上都可以一起獲得新能力。
需要提一下的是,這裡最容易產生一個誤解,100萬AI研究員,並不會自動帶來1000倍研發速度。
科研天然存在邊際收益遞減,10個人研究一個問題,可能比1個人快很多。
100萬人同時研究一個問題,很可能大量重複工作、爭搶實驗資源,還會發現好點子越來越難找。
所以論文真正試圖計算的是另一件事:新增AI研發勞動力帶來的收益,究竟能不能跑贏科研本身越來越難這件事捏?
於是乎,整篇論文非常關鍵的一個變數來了:returns to research effort,記作r。
簡單理解,就是研究投入增加以後,技術進步速度能跟著漲多少。
當r比較低,大量增加研究投入以後,收益很快遞減。
當這個數足夠高,新增研發能力帶來的進步,又會進一步造出更強的AI研究員,這時反饋環才開始加速。
論文引用了一項對三個AI研究子領域歷史資料的研究,r的中心估計落在大約1.2—1.9。
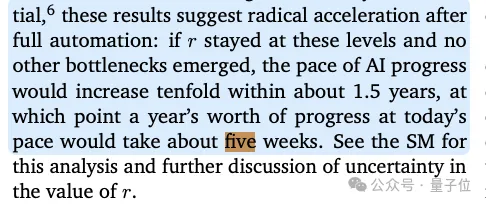
假設AI研發實現全面自動化,假設類似的研究回報能夠維持,再假設短期內沒有新的算力、資料等瓶頸突然卡死整個系統,模型得到的結果是:
AI技術進步速度可能在大約1.5年內提高10倍。
換算一下啊,今天需要一年才能發生的AI進步,到了那個階段,只需要大約5周。
而且論文還算了另一筆帳。
如果AI研發全部自動化以後,只維持當前軟體效率改進趨勢,自動化AI研發勞動力在數月到數年時間裡,就可能擴大100倍。
而且這種增長還可能來自兩條線同時推進。
一邊是AI研究員數量增加,一邊是單個AI研究員本身繼續變強。
於是智能爆炸真正反常識的地方出來了。
過去科技增長的一項天然限制,是培養研究人員很慢,培養一個真正優秀的研究員,需要十幾年教育和訓練。
AI研究員可沒有這層限制,一旦達到足夠能力,培養這個步驟可能變成複製模型、分配算力。
於是乎,科研第一次可能遇到一種極其奇怪的供給衝擊:研究能力本身,也變成了軟體。
而且一旦研究能力變成軟體,研究員數量和研究員能力這兩個變數,就有可能同時被技術進步推動。
這才是論文口中的智能爆炸真正危險的地方:加速來源本身也在被加速。
RSI已經冒頭,智能爆炸還沒閉環
看到這裡,很容易得出一個特別刺激的結論:完蛋,智能爆炸已經開了。(哭)
但咱辛頓這篇論文裡,全篇給出的一個基調是,當前證據還遠遠不足以證明智能爆炸已經發生。(笑)
因為目前AI研發自動化帶來的生產率提升,依然沒有明確越過引發爆炸式加速所需要的門檻。
作者甚至直接提醒,AI研發自動化和智能爆炸之間,中間還隔著很長一串條件。
AI首先得足夠可靠,能夠長時間自主工作;其次要真的提高研發產出;再然後,這些新研發成果還得反過來明顯增強AI本身的研發能力。
而且即使未來出現幾百萬個AI研究員,它們面前至少還有幾道很現實的牆。
第一道,算力。
AI研究員可以複製,GPU不能憑空複製,如果大量關鍵實驗都需要運行大型模型,再多Agent最後也可能排隊等卡。
尤其訓練一次真正的前沿模型,本身就可能需要數月,100萬個AI研究員坐在電腦前,也沒法把一個物理上需要三個月的訓練任務壓成五分鐘。
這也是軟體驅動智能爆炸最大的現實約束之一:軟體迭代可以極快,底層計算基礎設施擴張依然受物理世界限制。
第二道,資料。
網際網路天然資料並不會隨著AI研究員數量同步增長。
按照論文討論的趨勢,現有高品質自然資料很可能越來越難滿足持續擴展的訓練需求。
未來能不能靠合成資料、可驗證任務、環境互動等方式繼續提供高品質訓練訊號,現在依然沒有定論。
第三道,實驗時間。
有些事情本身就很難無限平行,訓練模型需要時間,晶片製造需要時間,新資料中心建設也需要時間。
那怕有100萬個Agent同時提出實驗方案,最終還是要共享有限的GPU、實驗叢集和訓練窗口。
還有最後一道更根本的問題,那就是科研會越來越難。
容易找到的演算法改進可能首先被找光,往後每提高一點能力,都需要越來越大的投入。
論文把這一點叫作diminishing returns——
研究越往前走,下一次突破可能就越貴,如果科研難度上漲得比AI研發能力還快,智能爆炸自然也起不來。
總的來說,雖然論文沒有足夠證據證明智能爆炸一定發生,但現有證據已經足夠讓它從科幻問題,變成一個需要提前準備的現實問題。
而且遞迴自我改進這件事,確實已經離「科幻設定」越來越遠了。
甚至未來回頭看,2026年真正值得記住的節點,可能還真不是某個模型又多拿了幾分。
恐怕是人類第一次開始認真意識到,AI最猛的一次Scaling,可能發生在「研究AI」這件事本身。 (量子位)