
內存短缺正成為AI擴張的最大"卡脖子"難題,但產業界並未坐等晶圓廠救場。降規、推理負載分離、CXL內存池化——三條繞道策略正在重塑AI算力格局,並催生新投資機會。摩根士丹利點名$Astera Labs (ALAB.US)$、 $邁威爾科技 (MRVL.US)$ 、 $Cerebras Systems (CBRS.US)$ 為核心受益標的,同時維持 $美光科技 (MU.US)$ 與$閃迪 (SNDK.US)$增持,判斷本輪內存短缺周期遠未終結。
內存短缺已成為本輪AI建設周期中最持久的結構性制約,而AI算力擴張的腳步不會等待新晶圓廠落地。面對這一矛盾,整個產業鏈正在探索三條繞道而行的路徑——降低內存規格、拆解推理負載,以及通過CXL技術實現內存池化共享——並在此過程中催生出新的投資機會。
摩根士丹利在最新研究報告中指出,$輝達 (NVDA.US)$CEO黃仁勳近期已明確表態,行業需要以全新思維應對內存瓶頸。這並非悲觀信號,而是產業界對未來數年持續短缺的主動預判。內存緊缺的烈度或有起伏,但AI將在可預見的未來基本吸收全部可用供應。
在投資層面,摩根士丹利將Astera Labs(ALAB)和Marvell(MRVL)列為CXL及規模擴展方向的潛在受益者,將Cerebras(CBRS)列為推理負載分離架構的核心受益標的,同時維持對Micron(MU)和SanDisk(SNDK)的增持評級,邏輯在於內存短缺周期遠未終結。
降規:治標之策,壓力轉移而非消除
面對DRAM和NAND價格雙雙走高,生態鏈企業最直接的應對是壓縮單設備或單服務器的內存配置。
摩根士丹利指出,輝達正在為Rubin平台向客戶提供多個規格版本:LPDDR5每機架容量從原定54TB壓縮至28TB,對應模組從192GB SOCAMM2縮減至96GB;HBM方面,Rubin原計劃每GPU搭載288GB HBM(8疊12hi HBM4),目前預計將推出192GB版本(8疊8hi HBM4)。對於Rubin Ultra,相關規格也從1TB HBM4e下調,實際可比基準或降至192GB至384GB區間。
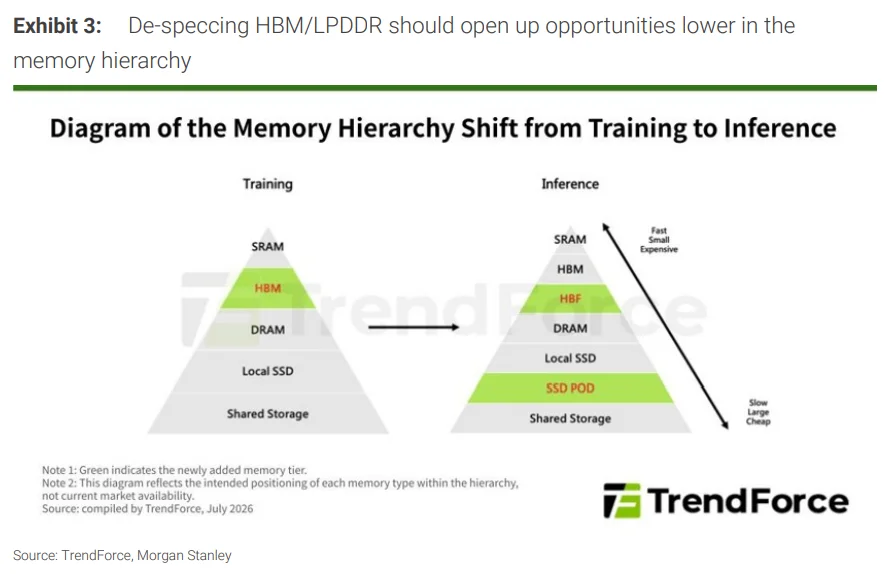
然而,降規並非真正意義上的解決方案。報告強調,當一層內存容量被削減,數據壓力必然向下轉移,HBM和LPDDR的縮水正在為NAND和網絡互聯帶來增量需求,內存瓶頸發生了位移而非消失。
推動AI內存需求持續擴張的結構性因素包括三個維度:模型規模在LLM時代每6個月翻倍;上下文窗口長度以每年約5倍的速度擴張;推理併發量的增加使每個會話均需獨立記憶體KV緩存。
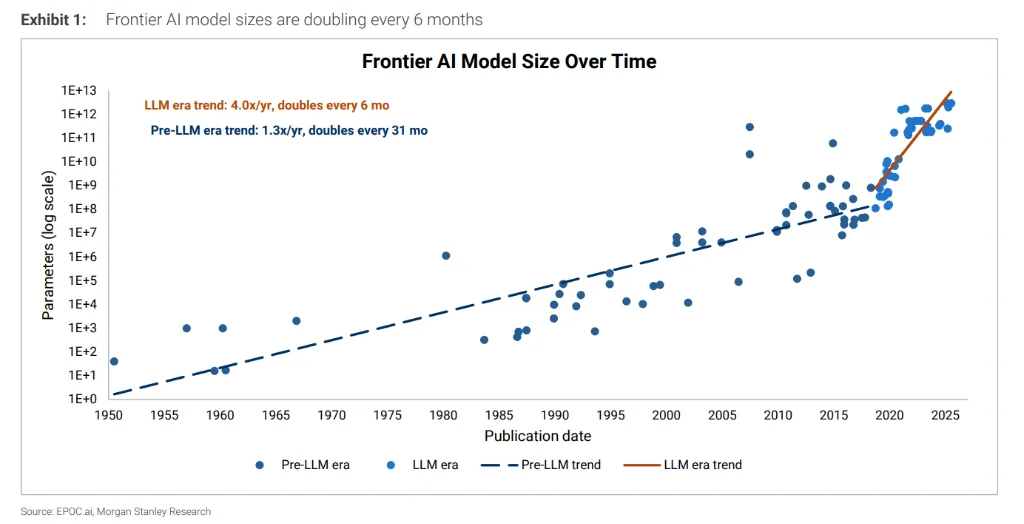
摩根士丹利認為,這三個向量的持續演進決定了降規只能是臨時性措施,一旦供應緩解,行業將迅速回補至更高規格,被壓制的需求將更容易被吸收。
負載分離:為不同推理階段配置專屬硬體
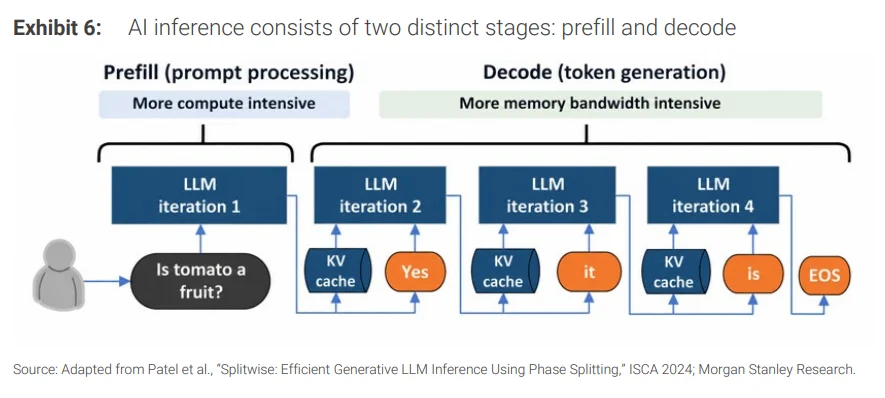
推理過程由兩個截然不同的階段構成:預填充(prefill)以並行方式處理輸入提示詞,計算密集;解碼(decode)逐token生成輸出,對內存帶寬和容量的依賴更為突出。將二者分離,分別交由最適合各自特性的硬體處理,是提升內存使用效率的第二條路徑。
這一趨勢在2025年底前後明顯提速。輝達收購Groq後,將其LPU(基於高帶寬片上SRAM)整合進Vera Rubin平台,由Rubin GPU負責預填充及需要大容量KV緩存的解碼環節,Groq處理前饋和專家混合部分,輝達Dynamo負責協調與啟動值傳輸。AWS隨後宣佈以Trainium負責預填充、Cerebras負責解碼的異構架構,並計劃於2027年第一季度在$亞馬遜 (AMZN.US)$Bedrock上線;Cerebras與AMD的類似合作方案則預計於2026年第四季度投入生產。$MATRIX (5236.MY)$的Corsair也已進入量產階段。
摩根士丹利將Cerebras列為負載分離架構中最直接的純正受益標的。Cerebras晶圓級處理器將大量SRAM與計算單元整合於同一矽片,顯著降低數據在處理器與外部內存間的移動頻率,在解碼階段優勢突出。更重要的是,負載分離可實質性改善Cerebras Cloud的經濟模型——據Cerebras與AMD披露,聯合系統可在維持Cerebras推理速度的前提下將吞吐量提升最高5倍,每部署單元可產生更多收入,每token成本同步下降。
CXL:從內存擴展到AI推理的新戰場
CXL(Compute Express Link)是一種基於PCIe物理層的高速互聯協議,核心價值在於允許多個處理器訪問同一內存資源池,從根本上打破了內存與特定CPU綁定的傳統架構。
其三種主要應用形態為:內存擴展(為單處理器加入超出本地內存通道上限的容量)、內存共享(多處理器訪問同一數據)以及內存池化(跨處理器或服務器動態分配內存,減少閒置浪費)。
摩根士丹利指出,過去CXL主要服務於通用CPU計算場景,在AI領域的滲透因延遲劣勢而受限。但隨著推理場景對長上下文、代理型工作負載和KV緩存的容量需求急劇擴張,大量數據並不需要始終駐留在HBM中,CXL掛載DRAM作為更低成本、更大容量的內存分層由此獲得立足空間。
市場規模方面,摩根士丹利將CXL的可尋址市場預測從原先以CPU為基礎測算的逾40億美元上調至2030年約60億美元,增量主要來自AI服務器側的新部署場景。Astera Labs的Leo內存控製器系列(含針對KV緩存卸載的定製設計,預計2027年量產)以及Marvell覆蓋內存擴展(Structera X)和機架級池化(Structera S)的全線產品組合,是摩根士丹利看好的兩個核心標的。Marvell管理層此前已將CXL定位為2028年前後逾10億美元的收入貢獻來源,摩根士丹利預計在即將舉行的投資者日上將獲得更多細節披露。
對內存股的影響:周期邏輯以時長而非振幅為錨
摩根士丹利坦承,從短期盈利最大化角度看,上述繞道策略對DRAM廠商存在一定負面影響——若AI生態因內存短缺而完全停擺,近期定價可能更為有利。但這一情形從未現實,報告強調,分析本輪內存周期應以"持續時長"為主要驅動邏輯,而非價格振幅。
核心論據在於:降規源於供應約束而非需求消退,一旦供應改善,行業將迅速回補至更高規格,被壓抑的需求將輕易消化新增產能。摩根士丹利同時提示了一個風險因素:若AI放緩並非由於需求下降,而是源於土地、電力或廠房等基礎設施瓶頸,此類暫停可能對內存類股造成不同於算力類股的特有衝擊。
基於上述判斷,摩根士丹利維持對MU和SNDK的增持評級,認為內存短缺周期尚未終結,兩者的配置價值仍然成立。 (華爾街見聞)