
從GPU主導到CPU反超:智能體推理改寫算力結構
當每塊GPU需要80個CPU核心來伺候,記憶體行業的遊戲規則正在被改寫。
80個CPU核心,伺候一塊GPU。這是瑞銀2026年5月一份報告裡最刺眼的數字。傳統AI訓練,一塊GPU配置8到12個CPU核心就夠了;到了智能體(Agentic AI)推理,這個數字變成80到120個——增長5到10倍。
更顛覆的是算力分配方向。瑞銀援引的專家訪談給出判斷:傳統AI工作負載裡,70%到80%的算力消耗在推理本身(GPU)上;而在智能體推理中,這個比例反轉了——70%到80%的工作量轉移到了CPU上。
一塊GPU要十個CPU核心伺候,一半以上的活已經不歸GPU管了。瑞銀據此預測:伺服器CPU市場規模將從2025年的約300億美元增長至2030年的約1700億美元,五年漲近5倍。
問題隨之而來:AI從訓練轉向推理,到底改變了什麼?為什麼DDR5突然變得比HBM還重要?
一、智能體推理到底改變了什麼?
從"一問一答"到"持續循環"
傳統大模型推理是簡單的問答模式:使用者提問,模型回答,結束。智能體AI完全不同。它需要持續進行"思考—執行—觀察—反饋"的循環:完成一個任務需要多輪推理,每一步推理後呼叫工具、檢查結果,再決定下一步。這種循環意味著更大的計算量和更複雜的資料互動。
智能體是典型的DRAM密集型工作負載
智能體運行過程中需要維護長上下文記憶和歷史資料——這些資料必須隨時可訪問。隨著上下文窗口擴大和任務複雜度提升,KV Cache(鍵值快取)用量急劇膨脹。瑞銀指出,這些正是典型的DRAM密集型工作負載,DDR5的重要性將快速提高。
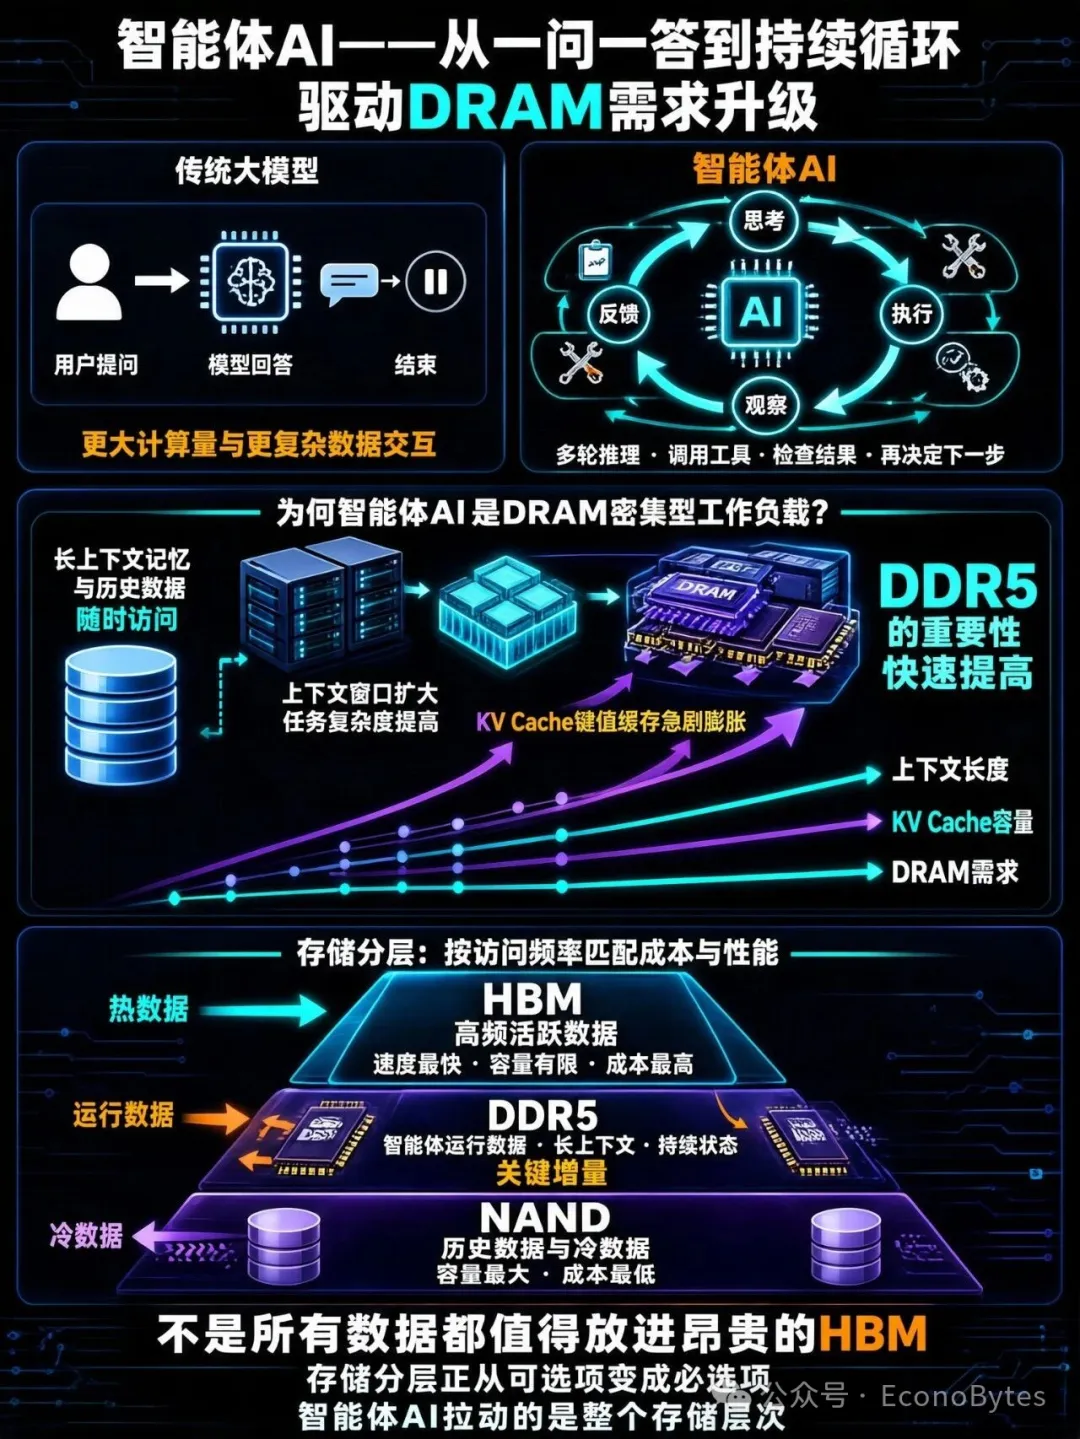
這裡藏著一個關鍵判斷:不是所有資料都值得放在昂貴的HBM裡。活躍資料放HBM,運行資料放DDR,歷史和冷資料下沉至NAND——記憶體分層正在從"可選項"變成"必選項"。
為什麼CPU變得關鍵
在智能體場景中,CPU承擔了大量序列計算:任務編排、狀態管理、工具呼叫、資料讀取、結果驗證。
論文《AgentCgroup》的測算顯示,編碼智能體中容器初始化加上工具執行佔端到端任務時延的55%到60%。Intel引述的一項CPU-Centric研究顯示,編碼智能體中僅工具執行一項就佔請求響應時間約60%(深研智能體約50%、科研智能體約36%)。
一項來自佐治亞理工學院與Intel的研究(《A CPU-Centric Perspective on Agentic AI》)顯示:五大代表性智能體工作負載中,CPU端的工具處理、邏輯調度、資料預處理佔總端到端延遲的84.5%到90.6%,遠高於GPU端模型推理佔比。
這些環節幾乎全部壓在通用計算上——GPU使不上勁,也不該使。
智能體不是"更強的推理",而是"不同類型的計算"——大量序列、調度、編排類工作,天然屬於CPU的領地。
二、CPU與GPU的配比正在反轉 ★
從1:8到1:1的演進路徑。傳統訓練負載,CPU與GPU配比約1:8,CPU主要作為主機節點存在。這個數字有多個來源印證:Intel CEO陳立武在2026年4月財報電話會上表示,"CPU與GPU的比例過去是1:8,現在是1:4,未來可能走向持平甚至更高";野村證券的判斷是訓練階段約7-8塊GPU配1個CPU,推理階段收緊至3-4:1。
推理負載,配比收緊至約1:4。智能體推理,配比進一步向1:1靠攏。AMD CEO蘇姿丰在2026財年第一季度財報電話會上(2026年5月)給出明確判斷:"傳統資料中心裡CPU與GPU的比例多為1:4或1:8,主要作為主機節點;隨著智能體AI普及,這一比例正在向1:1靠攏,甚至在智能體密集部署的場景下,CPU數量可能超過GPU。"
驅動因素是多層級的。瑞銀量化了這種轉變的規模:伺服器CPU總可定址市場將從2025年的約300億美元增長至2030年的約1700億美元。注意這是瑞銀口徑——同期伯恩斯坦給出的是390億到2230億美元、美銀給出350億到1710億美元,機構間的絕對量級有差異,但"五年數倍增長"的方向一致。
結構上:主機節點CPU佔比將從2025年的29%提升至2027年的41%(瑞銀)。任務粒度上:複雜智能體任務可能生成10到100個子智能體,每個子智能體需要1到4個專用CPU核心(瑞銀援引專家訪談)。相較傳統編排的1個核心,這是數量級的躍升。Arm給出另一個維度的測算:傳統AI資料中心每吉瓦(GW)約需3000萬CPU核心,智能體AI場景約需1.2億核心——4倍提升。
為什麼CPU不能被GPU取代?GPU擅長平行計算——矩陣乘法、張量運算,這些是訓練的核心。但智能體的任務是序列的、有依賴關係的:先規劃,再調工具,再檢查結果,再決定下一步。每一步都依賴前一步的輸出。這種序列邏輯編排、狀態管理、工具呼叫協調,恰恰是CPU的強項。
一位產業人士的概括很精準:GPU靠單卡峰值定價,賣的是天花板;CPU靠單位算力的吞吐和時延定價,賣的是"用得起"。
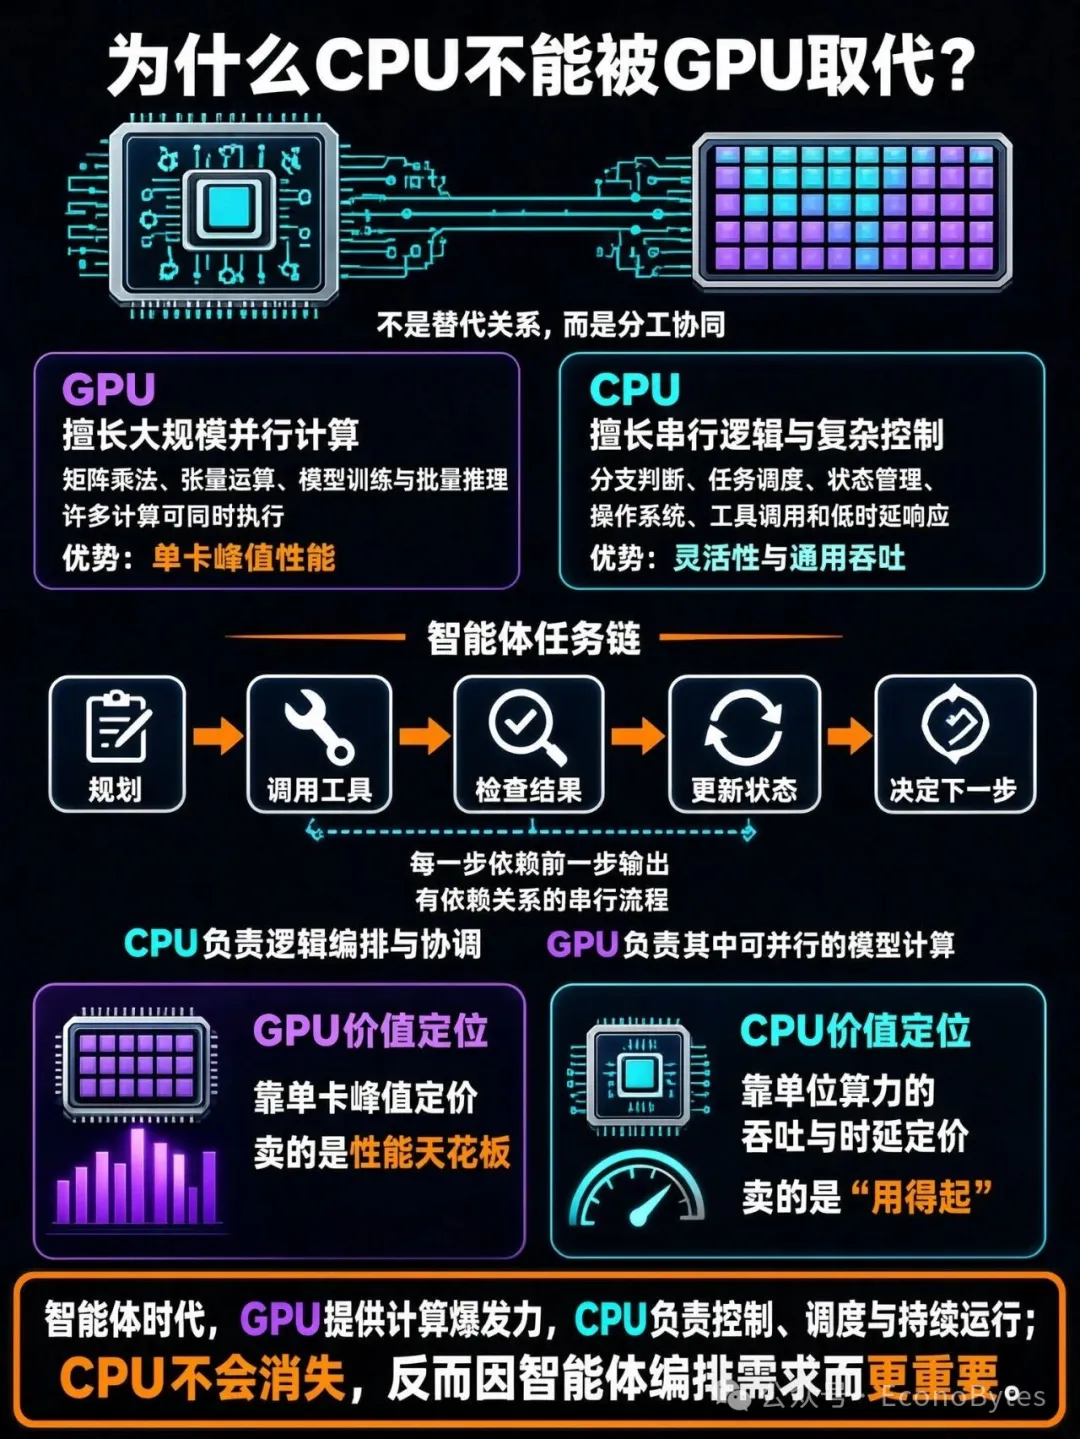
需要說明的是,這不是"CPU蠶食GPU"。蘇姿丰對此給出否定答案——加速器運行基礎模型需要CPU配合,智能體還會"衍生"出大量CPU任務,CPU需求"很大程度上是對GPU市場的補充"。CPU不是"王者歸來",而是"角色升級"——從輔助節點變成核心計算資源。
三、伺服器DDR需求:十多年未見的增速
瑞銀預計伺服器出貨量2026年增長19%,2027年繼續增長17%。伺服器DDR需求將在2026年增長44%,2027年進一步增長70%。瑞銀在後續報告(2026年9月)中進一步上調:伺服器DDR位元容量需求2027年同比增長約80%。放在記憶體行業過去十多年的歷史中,這樣的增速極為罕見。
從"可選"到"剛需"。傳統AI伺服器中,DRAM只是標配;智能體推理場景下,DDR5直接決定了能同時運行多少個智能體、支援多長的上下文。
配置量的躍升很直觀:通用伺服器通常配置DDR5 512GB至1TB,而AI伺服器DDR5配置達1.5TB至4TB(CFM/CFMS MemoryS 2026)。據瑞銀測算,伺服器平均DRAM容量將從2026年的927GB提升至2027年的1455GB。產品側也在跟進:美光256GB DDR5 RDIMM已於2026年5月12日開始送樣,採用1γ工藝與3D堆疊+TSV,速率最高9200 MT/s,功耗較2×128GB模組降低約40%。
瑞銀明確指出,智能體AI正是關鍵引擎——不僅推動HBM需求增長,同時帶動DDR5/LPDDR5以及NAND快閃記憶體需求增長。過去幾年市場把AI記憶體的紅利幾乎全部歸給了HBM,但瑞銀認為市場嚴重低估了智能體AI對整個記憶體產業鏈的拉動作用——DRAM最大增長來源已不再是手機和PC,而是AI伺服器。
四、46%:DRAM需求結構的根本性反轉
2025年,伺服器DDR佔整個DRAM需求的比例約為31%。到2027年,這一比例將躍升至46%(瑞銀2026年5月版)。這意味著,DRAM行業最大的增長來源已經從手機和PC轉向AI伺服器。
過去十多年,DRAM需求結構相對穩定:手機約佔40%,PC約佔20%,伺服器約佔30%(WSTS/J.P.Morgan口徑)。智能體AI正在打破這個格局。群智諮詢預測,2026年AI伺服器在DRAM總出貨容量中的需求佔比將突破40%,2027年攀升至49%,2028年突破50%並維持50%至55%區間,正式佔據DRAM行業需求的主導地位。集邦諮詢(TrendForce)的預估顯示,伺服器佔DRAM位元需求的比重將從2026年的42.2%升至2027年的43.7%。
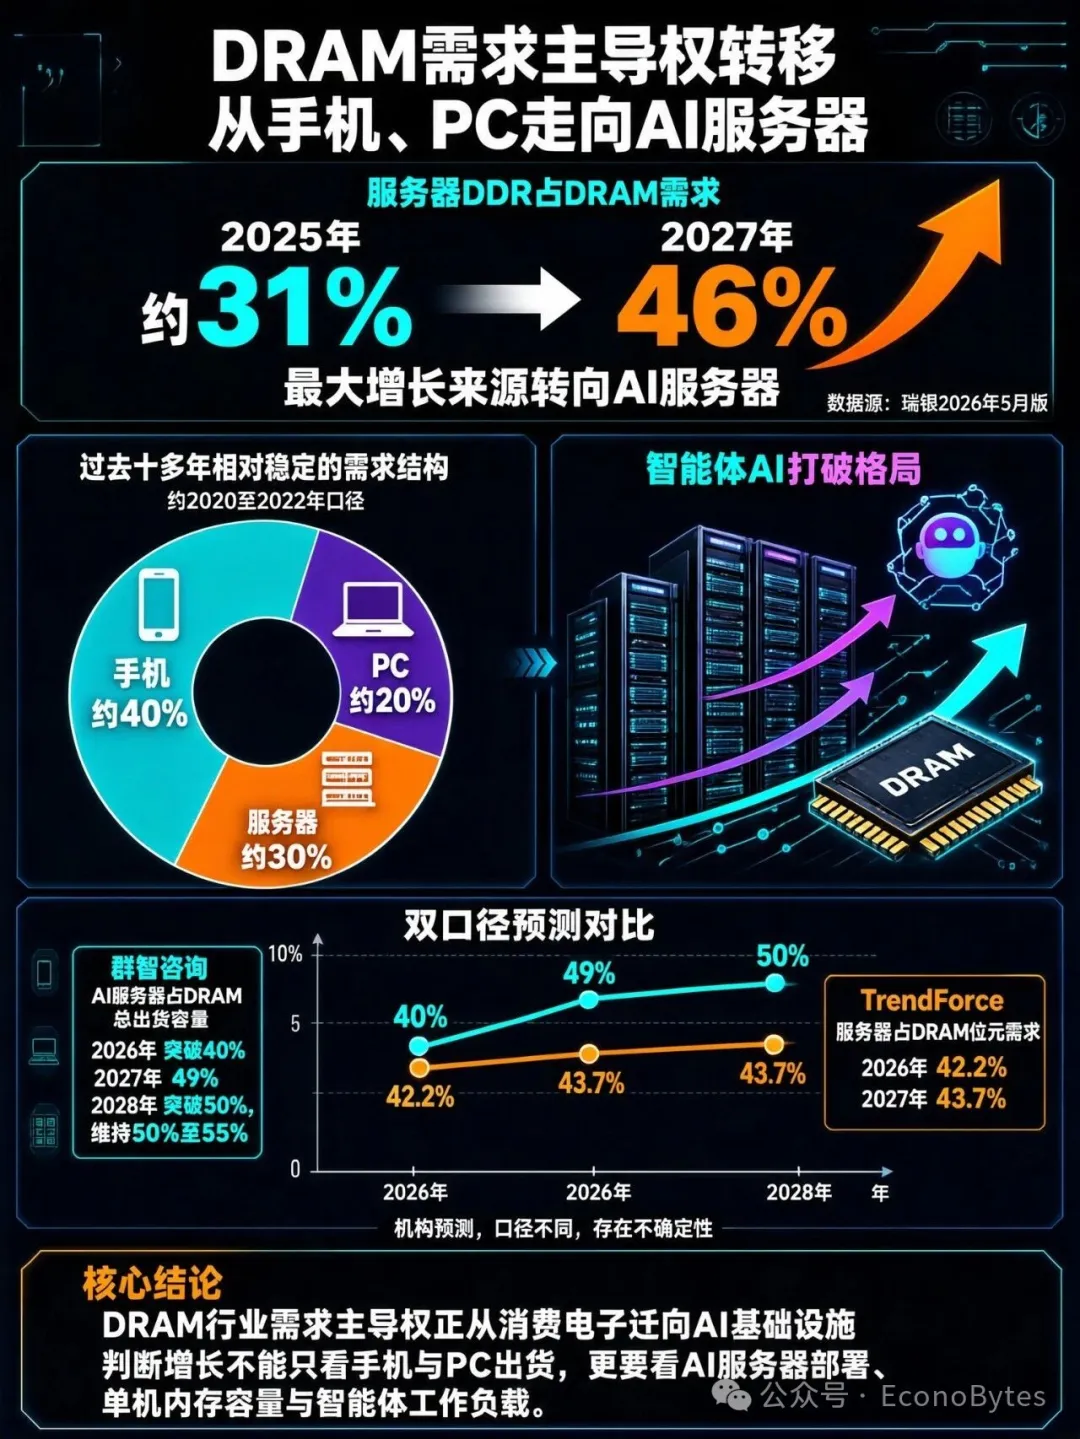
為什麼是結構性反轉?手機和PC的DRAM需求增速是線性的——跟隨出貨量波動。AI伺服器的DRAM需求增速是指數級的——單機容量持續提升,伺服器出貨量也在增長。兩個變數疊加:瑞銀預計2027年伺服器出貨增長17%,單台伺服器記憶體容量增長約50%,兩者疊加約80%的需求增長。
DRAM行業花了二十年把手機變成了第一大市場,現在智能體AI正在用兩年時間把伺服器推上王座。
五、記憶體分層:不是所有資料都值得放在HBM裡 ★
NAND迎來第二波AI紅利。瑞銀大幅提高了NAND需求預測,核心驅動力來自KV Cache。隨著上下文窗口越來越長、智能體越來越複雜,這部分快取資料將持續膨脹,不可能全部留在HBM和DDR中。
產業實踐已經驗證這一趨勢。華為在2026年9月的全聯接大會上發佈OceanStor M900記憶記憶體方案,將超節點的KV Cache從視訊記憶體與記憶體擴展至SSD,單叢集可提供64PB容量,單NPU可用KV Cache容量從GB級提升至TB級,時延降至60微秒。
以DeepSeek為代表的AI企業正積極推廣KV快取方案,將優先順序較低的快取資料從高性能記憶體遷移至高速大容量QLC固態硬碟。記憶體原廠也在跟進:三星在FMS 2026發佈zNAND-O方案,將唯讀佔大頭的模型權重下沉到zNAND,OS/應用/KV Cache/啟動資料保留在DRAM中。模擬測試顯示,記憶體成本可大幅降至約原來的六分之一,而推理性能與純DRAM系統幾乎持平,可記憶體的模型規模接近兩倍。
記憶體分層為什麼是必然?HBM貴且容量有限,不可能把所有資料都放進去;DDR5容量更大但成本仍高,適合放運行資料;NAND容量更大、成本最低,適合放歷史和冷資料。
NAND的容量優勢並非"HBM的千倍"。採用HBF(高頻寬快閃記憶體)等堆疊方案後,同等物理空間下NAND容量可達HBM的8到16倍(SanDisk/SK海力士FMS 2026)。"千"對應的是NAND的堆疊層數,不是容量倍數。
記憶體產業的估值邏輯正在改變。瑞銀已將美光的估值錨從"周期性的P/B"切換為"成長型的P/E"——這是估值框架層面的轉變。媒體將其表述為目標PE從過去的8到10倍拉升至25到30倍區間;瑞銀報告原文的表述是以約15倍遠期市盈率(錨定2029年EPS)折現估值。雖然資料口徑存在差異,但"從周期轉向成長"的定性判斷一致。同時,超大規模雲廠商已通過增強型長期供貨協議,鎖定了Server DDR5約60%至70%的量。
智能體AI拉動的是整個記憶體層次的需求——從HBM到DDR5到NAND,每個層級都在膨脹。區別只是增速不同、價值量不同。
六、DRAM缺貨持續到2028年:預判需求持續性
供需缺口的持續性。瑞銀預計DRAM供不應求將持續至2028年第二季度,NAND供不應求將持續至2027年第四季度。具體到2027年:DRAM需求同比增長36.2%,遠超19.3%的供應同比增長,供需缺口擴大至約17個百分點。瑞銀將此次供需失衡程度描述為"過去30年來罕見水平"。
管道調研顯示,DRAM交付率預計維持在60%左右——也就是說,每10塊錢的需求,只能拿到6塊錢的貨。
為什麼需求不會快速回落?長期供貨協議改變了遊戲規則:全行業約60%至70%的伺服器級DDR5產量已被超大規模雲廠商通過三至五年的長期協議鎖定。這種模式削弱了傳統周期中"漲價→砍單→降價"的負反饋機制。同時,智能體AI的普及仍在早期階段——目前的KV Cache和上下文窗口遠未達到上限。
DDR5需求的持續性不是短期脈衝,而是由智能體AI工作負載特性決定的結構性趨勢。
對讀者的判斷提示。判斷DDR5需求持續性,不能只看伺服器出貨量,要看三個變數:智能體部署密度(每台伺服器跑多少個智能體)、上下文窗口長度(KV Cache膨脹速度)、記憶體分層比例(多少資料下沉到DDR而非HBM)。這三個變數的增長曲線,決定了DDR5需求的上限在那裡。
傳統記憶體周期由供給驅動,這輪周期由需求驅動——智能體AI不是"一次性需求",而是持續消耗記憶體資源的"數字員工"。
結語:CPU反超不是口號,是正在發生的事實
從GPU主導到CPU反超,智能體推理正在改寫算力結構的底層邏輯。
算力配比反轉。CPU與GPU從1:8向1:1演進,智能體密集場景下CPU可能反超——每塊GPU配80到120個CPU核心是新的現實。
DDR5需求爆發。伺服器DDR需求2026年增長44%、2027年增長70%以上,2027年伺服器DDR佔DRAM需求46%—DRAM最大增長來源已不再是手機和PC。
記憶體分層加速。HBM管活躍、DDR5管運行、NAND管歷史—智能體AI拉動的是整個記憶體層次的需求,而非單一品類。
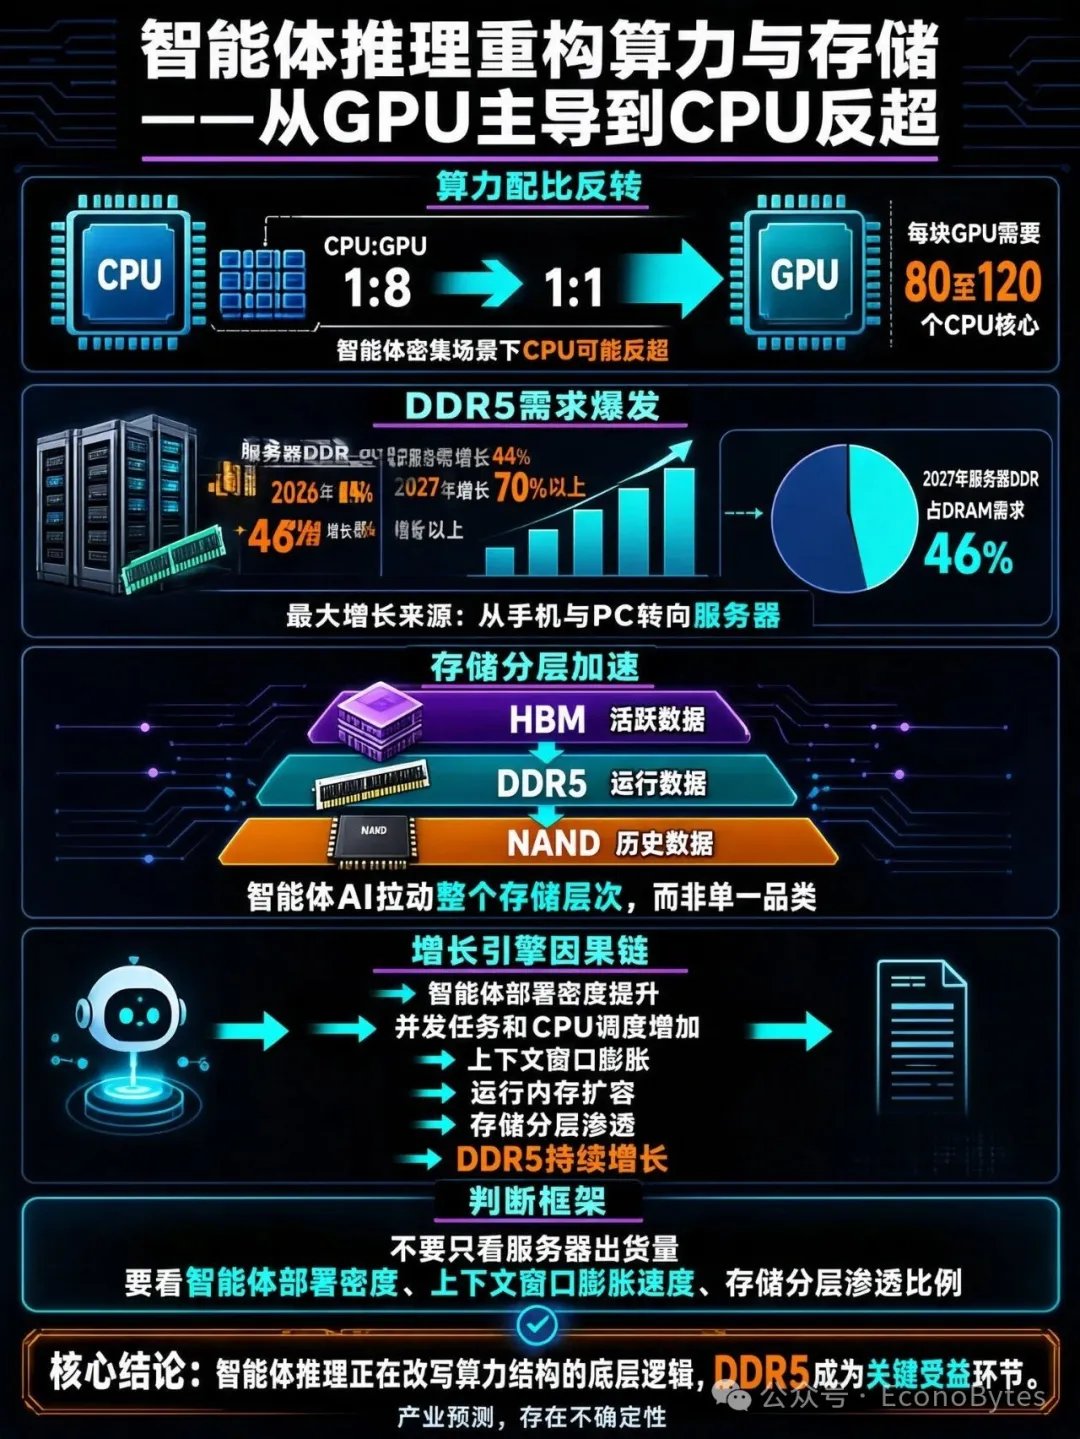
對讀者的啟示:判斷DDR5需求的持續性,不能只看伺服器出貨量,要看智能體的部署密度、上下文窗口的膨脹速度,以及記憶體分層的滲透比例——那才是DDR5真正的增長引擎。
當每塊GPU需要80個CPU核心來伺候,當DDR5的需求增速連續兩年超過40%,
記憶體行業的遊戲規則已經被智能體改寫了。 (EconoBytes)